エクストーンで Android エンジニアをしている石原です。2026年9月1日から3日まで、渋谷のベルサール渋谷ガーデンで開催されている DroidKaigi 2026 の Day2 に行ってきました。
事前にタイムテーブルを開いて、AIがらみのものに片っ端から印をつけていきました。自分としても関心ごとがAIでの開発ワークフローの改善なので楽しみにしてました。
で、聴き終わってから気づいたんですが、そのうち3本が 1ヶ月前に自分が書いた記事の続き になっていました。8月に AICore を Pixel 3台で実測した記事を出して、持ち帰ってほしいのは「そのモデルは誰が持っているのか」という問いだけです、と書きました。その問いに、会場から返事が来た感じがしています。
聴いたセッション
1. デバイス操作はAIエージェントの時代へ。mobile-mcpを活用したAndroid UI/E2Eテストの挑戦
LINE ヤフーの Mori Atsushi さんによる、AI エージェントに実機やエミュレータを操作させる話でした。
冒頭がいきなりライブデモです。個人開発されている楽譜編集アプリに、コーディングエージェントから「新しい楽譜を作成して、指定した音符を入力して」と依頼します。エージェントはアプリを立ち上げ、新規作成画面まで自力でたどり着いて、楽譜の上をドラッグして音符を置いていきました。途中で余計な音符を入れてしまう場面があったんですが、ここが良かったです。画面の状態をちゃんと見ているので、戻るボタンを押して自分で取り消していました。デモが完璧に決まるより、こういうところを見せてもらったほうが信用できます。
役に立つケースとして挙がっていたのが、実装後の軽い動作確認、不具合の再現調査、ストア用スクリーンショットの生成の3つです。逆に向かないケースが、最終的な合否判断、繰り返し実行するテスト、レイアウト検証、主観的な UX 検証の4つでした。遅くて高い、という理由が何度も出てきて、繰り返すテストはユニットテストや UI テストの仕事だ、と明確に線を引いていました。
自分にいちばん刺さったのは、後半の 「コード側を AI に読ませられる形に作り替える」 という話です。アイコンだけのボタンに contentDescription が無いと、エージェントからは名前のない画像にしか見えません。Compose なら testTag をリソース ID として出力させて、細かい位置情報を渡します。似た画面や新旧が併存している画面で誤検証されないように、いまどの画面にいるかを adb から取れるようにしておく。機能フラグの切り替えや課金状態の変更みたいな「検証したい内容とは本質的に関係ないけど毎回やる操作」は、BroadcastReceiver で外から叩ける口を用意して、デバッグビルドだけに閉じ込める。画面ごとの操作手順はリファレンスファイルに貯めて索引を1枚置き、そのファイル自体を定期的にエージェントに実装と突き合わせさせて PR を作らせるところまでやっていました。リファレンスが実装とずれると今度はそれが AI を混乱させる側に回るので、レビューが要る、と釘を刺していたのが誠実でした。
聴きながらずっと、社内で動かしている仕組みのことを考えていました。
担当している Android アプリには、リグレッションテストを回すための Conductor という仕組みがあります。Qase に登録されたテストケースを取ってきて、各ステップを Maestro・adb・logcat・手動のどれで実行するか分類して、実機で流して結果を書き戻します。その指揮を Claude Code に執らせる形です。リグレッションテストに毎スプリント数人日が溶けていたのを何とかしたくて作りました。
これ、Mori さんが「AI には向かない」と線を引いた、まさにその側の仕事なんですよね。なので対立する話ではなくて、同じ線の両側を別のもので埋めている、というのが正しい理解かなと思っています。エージェントが画面を毎回解釈して操作する方式は、初回の探索とバグの当たりをつける場面で強いです。決まった手順を何度も流す場面では、スクリプトのほうが速くて安くて、毎回おなじ結果が返ってきます。
面白いのは、下ごしらえの形がよく似ているところです。Mori さんは画面ごとの操作方法をリファレンスファイルに書き溜めて索引を置いていました。Conductor のほうは、Qase に人間向けに書かれた既存のケースをそのまま AI に読ませています。どちらも「画面と操作の対応表を、AI が読める場所に外出しする」という同じ形です。うちのほうが横着で、そのぶん立ち上がりは速かったんですが、AI に書かせて育てる方向は取り込めていません。ここは持ち帰りました。
もう一点、「ビルドなしで挙動を変えられる仕組みを用意しておくと便利」という話もありました。うちも同じことをやっていて、テスト用にデータベースへ直接データを流し込む仕組みを持っています。そして一度、これで痛い目を見ました。直接流し込むと、受信したデータを解析して保存するまでの処理をまるごと飛ばしてしまうんです。その区間に仕様との食い違いが埋まっていたのに、テストは全部通っていました。置き換える範囲は最小にする、というのがそこで得た教訓です。便利な口を開けるほど、本番の経路から遠ざかります。
2. 楽しみながら作るマルチプラットフォームウィンドウマネージャー
JetBrains の Sebastian Aigner さんによる、Kotlin Multiplatform と Compose Multiplatform でウィンドウマネージャーを作った話です。5本のうち唯一、AI がほとんど出てこない回でした。
動機は一言で「ノスタルジー」だそうです。Windows XP 時代の見た目に感情が動く、というところから始まります。中身は Compose の基本プリミティブの総ざらいでした。ウィンドウ枠と中身を分ける slot API、テーマが見た目だけを担当してクリック処理には触らないようにする InteractionSource、デスクトップ全体の状態をユーザーコードから触れるようにする CompositionLocal です。XP のスタイルには Luna というコードネームがあって、Linux 向けに Luna 風テーマを作っている人がいるそうです。その中身を開けたら、Android 開発者にはおなじみの 9-patch でした。それをそのまま Compose Resources に持ち込んでいます。
最小化しても動き続けてほしいウィンドウには既製の API が無いので、遠くのオフセットへ飛ばして「コンポジションには残っているが見えない」状態にする、という着地をしていました。iPad で Internet Explorer 風のウィンドウを最小化して戻すと、ページがリロードされずにそのまま戻ってきます。ここは会場が沸いていました。
締めが良くて、「Fen は次のプロジェクトで使わないでください。ただ Compose Multiplatform は使ってください」。そのあとに 「あなたのお気に入りの AI エージェントがすでに知っている API です」 と付け足していたのが、この日の他のセッションと静かにつながっていました。なお、Composable 関数の命名規則(Unit を返す UI 関数は PascalCase で名詞、値を返す関数は小文字始まりで動詞)は AI エージェントがいまだに混同する、という指摘もありました。心当たりがあります。
3. Google のオープンモデル Gemma を活用した最新の AI 開発のトレンド
Google DeepMind で AI Developer Experience を担当されている Juyeong Ji さんのセッションです。
導入の比喩が刺さりました。声で指示すると何でも出力してくれる 3D プリンターがあると想像してください、という話から入ります。「寿司ください」と頼むと、マグロが出てくるかもしれないし、卵が出てくるかもしれません。パンをください、肉をください、と分けて頼んで、最後に自分で重ねてハンバーガーにする人もいます。そんなプリンターは現実にはありませんが、テキスト生成では毎日それが起きています。そのうえで、Gemini は企業が持っている 3D プリンターに注文して家に届く形、Gemma は自分の家で組み立てる形、という置き方をしていました。組み立てはただでできます。ただし手入れと、機械を運用する知識が要ります。
デモは Google AI Edge Gallery から始まりました。機内モードにして Wi-Fi も切った状態で、日本語で俳句を書かせます。そこからマップのスキルを使う例に移って、音声で「渋谷駅あたりのカフェを地図に表示して」と頼むと、モデルが自分でツールを選んで実行しました。オンデバイスでツール選択まで届いているのを実機で見せてくれます。自分で環境を組むには3つの部品が要る、という整理も分かりやすかったです。頭にあたるモデル、モデルをロードして他のアプリから使えるようにする心臓、そしてツールを持って作業する体です。
最後がレゴで組んだキャラクターのロボットでした。Raspberry Pi を制御の中心に据えて、サーボで顔と腕と尻尾を動かします。ここで一言、Raspberry Pi 5 で Gemma を直接動かそうとすると相応のメモリを積んだモデルが必要で、そこまで予算をかける余裕がなかったので、言語モデルは同じネットワーク上の自分の PC に置いて接続している、と説明していました。さらっと流れましたが、ここは後で効いてきます。
4. ローカルAIランタイムでLow Memory Killerを生き抜く
SoumiS さんによる、端末の中で AI モデルを動かすときにメモリとどう戦うか、という英語セッションです。この日いちばん前のめりになりました。
理由は単純で、1ヶ月前に自分が書いた記事の、ちょうど続きだったからです。8月の記事では、2.6GB のモデルをアプリのプロセスで抱えた瞬間に Android の lowmemorykiller が他のアプリを次々に殺していく様子を、3台の Pixel で数えました。そこから「共有できるコストか、各自が払うコストか」で普及の形が決まる、という結論を出しています。
このセッションは、その殺される側から見た話でした。
LMKD は oom_score で優先順位を決めていて、キャッシュされたプロセスがいちばん先に、次にバックグラウンドのアプリ、その次にフォアグラウンドのアプリ、最後に OS とシステム UI という順です。フォアグラウンドにいるアプリの oom_score をゼロに保つのが、LMKD から得られる最大限の保護になります。ここで一つ、実務的にきつい指摘がありました。Java ヒープが溢れて落ちる場合はライフサイクルのコールバックが来るのでログもアナリティクスも残せますが、LMKD による kill は SIGKILL なので何も来ません。 何が起きたのか追跡する手段がなく、ユーザーからは「突然消えた」としか見えないわけです。
対策は積み上げ式でした。ComponentCallbacks2 の onTrimMemory で、UI が見えなくなった段階とバックグラウンドに落ちた段階の信号を受けて、再構築できるリソースを解放し新規確保を止めます。Java ヒープからテンソルを追い出すには SharedMemory を使う。ネイティブ側で動く推論エンジンとの間でコピーが要らなくなって、GC の対象からも外れます。物理 RAM そのものが足りないなら mmap で、必要になったページだけを載せるデマンドページングを使います。デモアプリにトグルが用意されていて、mmap を切った状態では載らなかった規模のエンジンプールが、入れると同じ端末で動いていました。
ハードウェアの選び方も整理されていました。CPU に重い計算をさせるとサイクルを食って熱で絞られフレーム落ちを招きますし、GPU は UI の描画と競合します。だから NPU を使う。かつての NNAPI は非推奨になっていて、いまは LiteRT の CompiledModel でアクセラレータを指定します。そして最後が、それでも殺されたときの備えでした。先行書き込みログを完全にコミットしてから実行しておけば、SIGKILL で何のコールバックも来なくても、最後にどの状態まで進んでいたかが分かるので復旧できます。
聴きながら、自分の8月の測定が、これらの最適化を一つも入れていない状態のものだったことに気づきました。
5. Androidに声を与える: リアルタイムエージェントの構築
M15.ai の Mark Wickham さんによる、リアルタイム音声エージェントを Android で組む話です。
最初に置かれたのが、コーディングに対する姿勢でした。「自分たちの仕事はソフトウェアアーキテクトだと考えればいい。コードはエージェントに書かせて、判断を助けるのが自分の役割」。要件を書いた Markdown を1枚用意して、アプリの素性と制約とアーキテクチャ、それにパイプラインの3要素(音声認識・LLM・音声合成)だけ埋めれば足場が組める、というやり方で、動く音声アプリを2時間で作れたそうです。
指標として前面に押し出されていたのが TTFT でした。音声認識と LLM を合わせて、最初のトークンが返るまでの時間です。効果的な音声システムの目標は1秒未満だそうです。紹介された3本のアプリはどれも計測用のクラスを持っていて、その場で数字が出るようになっていました。3本の構成を対比すると分かりやすかったので、以下に整理します。
3つの音声アーキテクチャの構成
| オンデバイス版 | クラウド版 | エージェント版 | |
|---|---|---|---|
| ネットワーク | 不要(すべて端末内) | WebSocket | WebRTC(Pipecat) |
| LLM | AICore | Claude Sonnet 4 | GPT-4.1 |
| 音声認識・合成 | ML Kit GenAI STT / Android TTS | Deepgram | Deepgram / Cartesia |
| 端末側の役割 | 全部 | 一部 | マイクとスピーカーだけ |
オンデバイス版は Pixel 10 の G5 で AICore を使っていて、TTFT は1秒を切っていました。トレードオフとして挙げられたのが2つあります。ハードウェアに縛られるぶん LLM の品質が及ばないこと、そして対応端末が高価で誰もが持てるわけではないことです。ただ日々良くなっている、と付け加えていました。クラウド版で強調されていたのは API キーを端末に置かないことで、短命な一時トークンが使えるプロバイダなら必ずそちらを選ぶべきだ、と話していました。エージェント版がいちばん割り切っていて、端末はマイクとスピーカーに徹して、知能はぜんぶサーバ側に置きます。この構成だと端末側にトークンも API キーも一切存在しないのが利点だ、という説明でした。
締めの1つ目が 「コードを書くな、アーキテクトせよ」。この日の朝に聴いた mobile-mcp の話と、昼に聴いた Compose Multiplatform の話に、別の角度からつながっていました。
1ヶ月前の記事に、返事が来た
8月の記事で自分が出した結論は、「技術の可否ではなく、コストの会計単位が普及の形を決めている」というものでした。同じサイズでも、OS が1つ持てば成立して、アプリごとに抱えれば1個目から破綻します。だからオンデバイス AI は OS の機能として降りてくる。そう書きました。
Juyeong さんの 3D プリンターの比喩は、そこに綺麗に重なります。注文して届く Gemini と、家で組み立てる Gemma です。組み立てはただだが手入れと運用知識が要る、というのは、自分が「借りるか、抱えるか」と書いたことの言い換えです。そして Juyeong さん自身、レゴのロボットでは Gemma を Raspberry Pi に入れることを断念して、PC に逃がしていました。抱えるコストの実演として、これ以上ないものを見せてもらった気がしています。
Mark さんのオンデバイス版も同じ場所に着きます。AICore を使うと1秒を切ります。ただし品質はハードウェアで頭打ちになりますし、端末も高いです。自分が「フラッグシップ限定」と書いた制約が、別の人の実装からそのまま出てきました。ちなみに Mark さんが画面に出していた AICore の feature 番号は 636 です。自分が8月に踏み抜いたのは、ライブラリが要求する番号が 636 から 648 に差し替わって、648 を配る AICore がまだ世に無かった、という回帰バグでした。同じ番号が別の人の発表資料に出てきて、ちょっと変な気持ちになりました。
問題は SoumiS さんのセッションです。
自分は「アプリがモデルを抱えると lowmemorykiller が他のアプリを殺す」を外側から数えて、だから抱えるのは無理がある、と結論しました。SoumiS さんは同じ現象を内側から見て、抱えたうえで生き抜く手を並べてきました。SharedMemory で Java ヒープからテンソルを追い出す。mmap とデマンドページングで、そもそも物理 RAM に全部載せない。ComponentCallbacks2 で、殺される前に自分から降りる。先行書き込みログで、殺されても戻ってこられるようにする。
自分の測定は、これらを一つも入れていない状態のものでした。素のままモデルを丸ごとプロセスに抱えて、殺された数を数えています。そこから「抱えるのは破綻する」と言い切ったわけですが、正確には 「素朴に抱えると破綻する」までしか言えていなかった というところです。会計単位が普及の形を決める、という骨格は変えなくていいと思っています。ただ、その会計に対して打てる手が実装側にこれだけある、というのは、自分の記事が扱えていなかった領域でした。
いちばん引っかかっているのは、8月の記事の後半に書いた後味の悪い一致のほうです。Pixel 9a で自前のモデルを回したとき、死んだアプリのログの中に TalkBack がいました。 オフラインが必須のアクセシビリティにこそオンデバイスが要る、という話と、廉価機では大きいモデルを回せない、という話が、同じログの上でぶつかっています。あれを書いたときは、端末の物理が決めることなので手の打ちようがない、という気持ちでした。SoumiS さんの話を聴いた今は、少なくとも「打つ手はあるので、測り直す価値がある」に変わっています。
もう一つ、5本を通して見えたことがあります。話の重心が、AI をどう使うかから、AI が触る前提でコードと端末をどう作り替えるか、に移っていました。Mori さんは、エージェントに読ませるために contentDescription と testTag とリファレンスファイルを整えて、外から叩けるコマンド口を用意していました。Mark さんは、自分の仕事をアーキテクトと定義し直していました。Sebastian さんは、AI エージェントがすでに知っている API を使え、と言い添えていました。三者三様ですが、どれも「AI が使う側に回ったときに困らない形」に自分たちの成果物を寄せる話です。
社内で AI First を掲げてやっていることと、同じ方向を向いていました。持ち帰るものが多い一日だったと思います。
会場の雰囲気
セッションの合間は会場をうろうろしてました。私がテンション上がったのは駄菓子屋です。
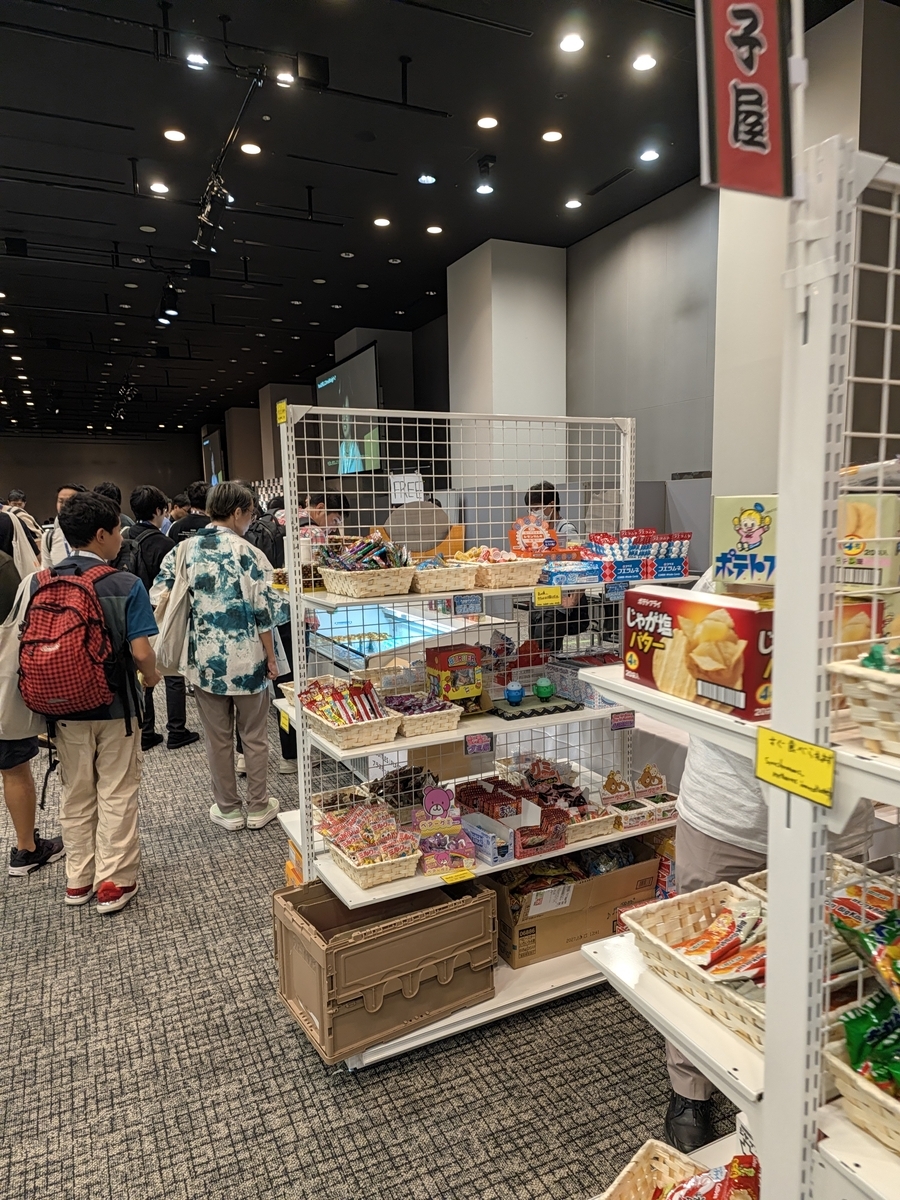
うまい棒もフエラムネもポテトフライもカゴに山盛りで、しかも全部 FREE でした。棚の前から人が途切れません。
その並びにアイスのコーナーがありました。
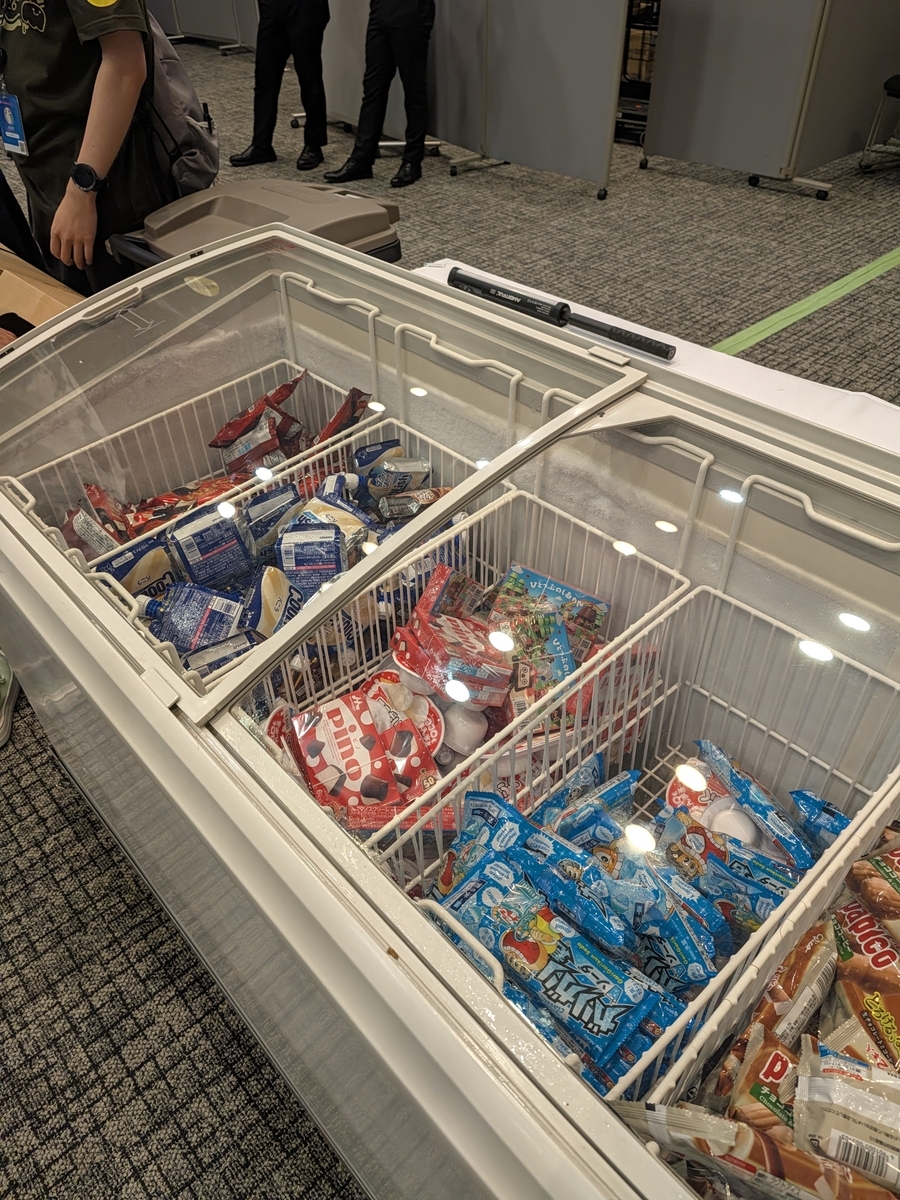
業務用の冷凍ストッカーが2台、ふたを開けるとパピコもクーリッシュも詰まっています。9月に入ったばかりでまだ暑い日だったので、これはかなり効きました。
コーヒーは Alpha Betti Cafe さんが淹れてくれます。
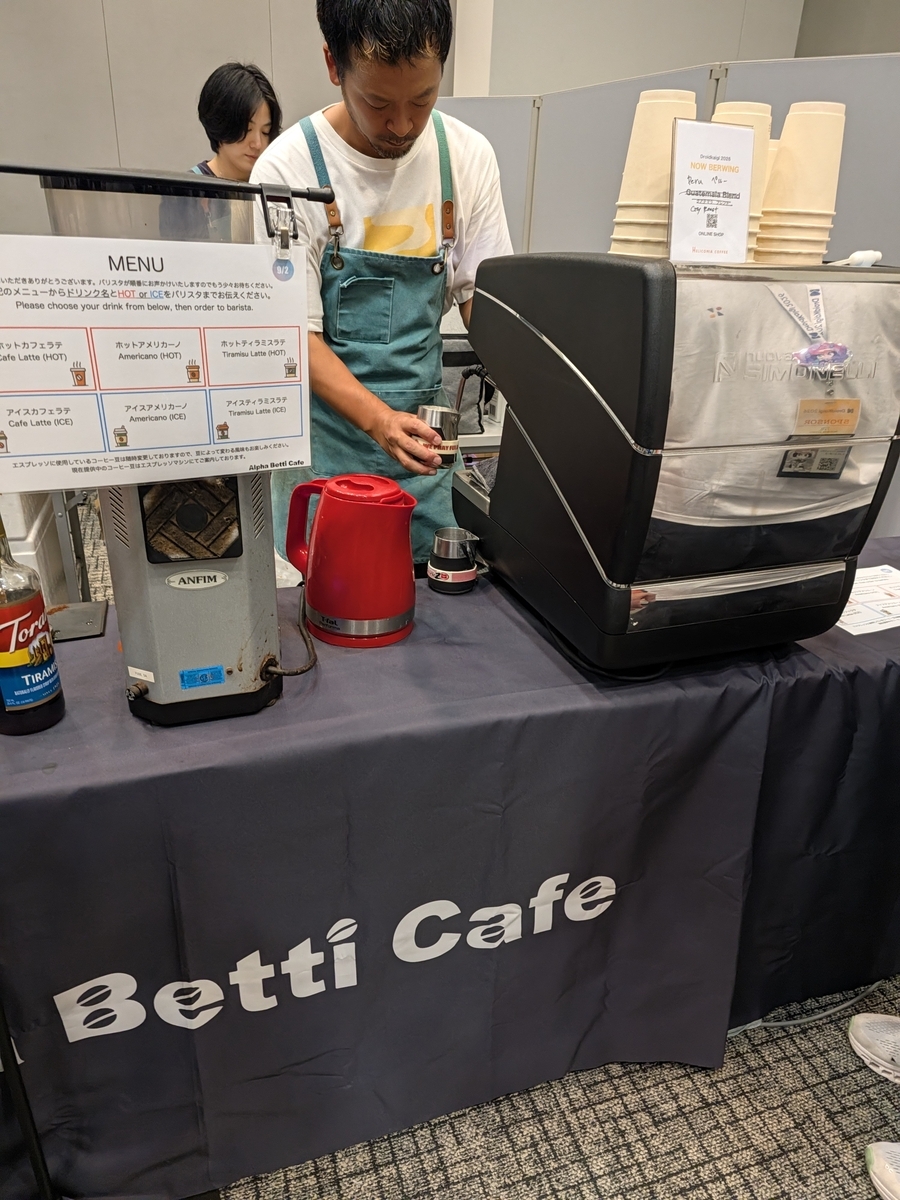
エスプレッソマシンを持ち込んで1杯ずつ淹れていました。この日の豆はペルーで、メニューにティラミスラテが並んでいるのが変わってます。列が途切れなくて結局飲みそびれたんですが、カンファレンスでこのクオリティのコーヒーが出てくるのは、けっこう贅沢だとおもいます。
おわりに
まず社内の Android プロジェクトで、アイコンだけのボタンの contentDescription を洗い出すところから始めます。エージェントに実機を触らせるための下ごしらえでもあるし、そのままアクセシビリティの改善でもあるので、とりくみます。そのあとで、8月の測定を SoumiS さんの手法を入れた条件でやり直します。Pixel 9a で TalkBack が死んだあのログが、共有メモリとデマンドページングを噛ませたときにどう変わるのか、自分の目で見ておきたいです。
Day3 には行けないので、自分の DroidKaigi 2026 はここまでになります。ただ、持ち帰ったものを試すほうは会場を出た時点から始まっていて、いまはそっちのほうが楽しみになっています。
本記事のセッション内容は、当日の聴講メモと録音をもとに再構成したものです。登壇者の発言そのものではなく、筆者の理解を通した要約である点をご了承ください。正確な内容は公式のセッションページや、公開されるアーカイブをご確認ください。評価・解釈は筆者個人の経験と観測に基づくもので、技術選択の妥当性はプロジェクトや要件によって変わります。
